

Každý, kdo někdy hledal judikaturu, zná ten pocit. Víte, že rozhodnutí existuje. Někde jste ho četli, možná jste o něm mluvili s kolegou. Ale v databázi hledáte už hodinu a stále nic. Co když jste na něco přece jen zapomněli?
Problém není ve vás a není ani v databázi. Je v tom, že klasické vyhledávání porovnává slova, zatímco vy hledáte myšlenku. Soud, který rozhodoval o pronajímání bytu přes Airbnb, nejspíš slovo Airbnb nenapsal. Napsal „krátkodobé ubytování třetích osob za úplatu“ nebo „užívání bytu v rozporu s účelem nájmu“. Stejná myšlenka, nula společných slov.
V tomto článku vysvětlíme, jak lze vyhledávat podle významu, nejen podle slov, a jak se to dělá v databázi, která má přes 900 tisíc rozhodnutí. Vysvětlíme, co je to vektorové vyhledávání, jaké má výhody a nevýhody, jak zajistit, že se na jeho výsledky dá spolehnout. A na konci si řekneme, kde všude se dá použít a na co si dát pozor.
Proč hledání podle slov v judikatuře selhává
Fulltextové vyhledávání dělá přesně to, co říká jeho název, a sice hledá v textu. Když hledáte například „okamžité zrušení pracovního poměru alkohol“, dostanete rozhodnutí, která obsahují tato slova. Je to předvídatelné a pro některé úkoly ideální. Pokud znáte spisovou značku, jméno soudce nebo přesnou formulaci právní věty, nic lepšího neexistuje.
Jenže většina rešerší nezačíná znalostí formulace. Klient přijde s tím, že jeho zaměstnanec přišel do práce opilý a klient, coby zaměstnavatel, ho na místě vyhodil. Vy potřebujete vědět, jestli to obstojí. Soud, který něco takového řešil, mohl psát o „požití alkoholického nápoje“, o „porušení povinnosti zvlášť hrubým způsobem“, o „stavu vylučujícím způsobilost k práci“.
Zkušený právník to řeší řemeslně. Hledá synonyma, paragraf, pročítá desítky výsledků, ukládá si výsledky do Excelu. Funguje to, ale stojí to hodiny práce, a i tak existuje riziko, že klíčové rozhodnutí leží na další stránce výsledků, kam se už právník ve své rešerši nedostane.
Právě tohle je mezera, kterou vektorové vyhledávání zaplňuje. Ne tím, že by bylo chytřejší, ale tím, že porovnává něco jiného než písmena. Vektorové vyhledávání je totiž schopné seřadit rozhodnutí podle významu.
Co je vektorové vyhledávání? Mapa, na které si blízké věci leží blízko
Jazykové modely posledních let umějí jednu věc, která dříve nebyla možná – převést text na polohu. Vezmou odstavec textu a vrátí dlouhou řadu čísel (třeba i tisíc). Tato čísla sama o sobě nic neznamenají. Důležitá je jediná vlastnost. Texty, které pojednávají o tomtéž, dostanou podobná čísla.
Nejsnáze si to člověk představí jako mapu. Každé rozhodnutí je na ní zobrazeno jako jeden bod, neboli GPS souřadnice. Rozhodnutí o výpovědi z nájmu leží v jednom kraji mapy, rozhodnutí o okamžitém zrušení pracovního poměru v jiném, náhrada újmy na zdraví ve třetím. Rozhodnutí o Airbnb leží hned vedle rozhodnutí o „krátkodobém ubytování třetích osob“, protože model pochopil, že jde o totéž.
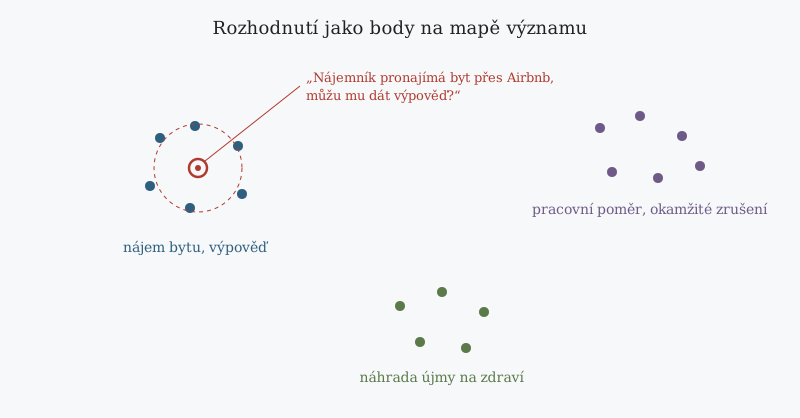
Mapa, která se skutečně používá, nemá dva rozměry, ale tisíc(e). Člověk si to nemůže představit, ale počítači je to jedno. Vzdálenost mezi dvěma body spočítá v tisíci rozměrech stejně snadno jako ve dvou rozměrech.
Hledání pak probíhá ve třech krocích:
- Vaše otázka se stejným modelem převede na bod na téže mapě, tedy na řadu čísel.
- Najdou se rozhodnutí, která leží nejblíž.
- Tato rozhodnutí se vrátí jako výsledek.
Konkrétní slova v otázce nehrají roli. Proto se můžete ptát tak, jak byste to popsali kolegovi, a nemusíte se obávat, že použijete špatnou formulaci otázky.
Na mapě není rozhodnutí, ale jeho popis
Rozhodnutí má tisíce slov a drtivá většina z nich je rekapitulace. Tvrzení žalobce, obrana žalovaného, průběh řízení v prvním stupni. Vlastní právní úvaha bývá až na konci a tvoří zlomek textu.
Kdybychom na mapu umístili celé rozsudky, jejich poloha by odrážela hlavně procesní rekapitulaci. Rozhodnutí o různých otázkách by splývala, protože všechna mluví převážně o průběhu řízení.
Proto ke každému rozhodnutí nejprve vytvoříme krátké shrnutí. To obsahuje zejména právní otázku, kterou soud řešil, výsledek a typ sporu. Shrnutí píše jazykový model, který rozhodnutí přečte celé. Na mapě pak leží shrnutí, nikoli rozsudek. Shrnutí je psané jako otázka a odpověď, tedy ve stejném formátu, v jakém se uživatel ptá. Dvě shrnutí psaná podobným způsobem leží na mapě blíže k sobě.
Jak porovnat milion rozhodnutí do jedné sekundy
Když má mapa 900 tisíc bodů a každý bod je popsaný tisícem čísel, porovnat otázku se všemi body znamená zhruba miliardu operací. Počítač to zvládne, ale zabere to nějakou dobu. Aby systém mohl odpovědět několika uživatelům najednou, nejdříve je potřeba jej optimalizovat.
Řešení, které používá každý systém tohoto typu, je tzv. index. Mapa se předem rozdělí na oblasti, v našem případě na asi tisíc. Když přijde otázka od uživatele, nejdřív se zjistí, do které oblasti tato otázka spadá, a prohledá se jen několik sousedních oblastí. Například, pokud víme, že se odpověď nachází v jedné z deseti oblastí z tisíce, ušetřili jsme 99 % operací porovnání.
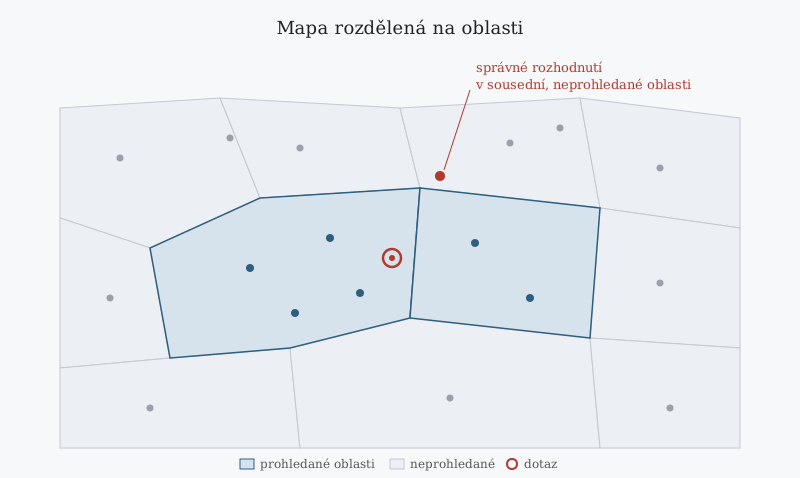
Ovšem, toto zrychlení není zdarma. Indexace násobně zrychluje vyhledávání, ale může také vést k chybám, konkrétně:
Hranice oblastí. Rozhodnutí, které je k otázce blízko, ale leží těsně za hranicí prohledávané oblasti, se do výsledků nedostane. Je tedy důležité zvolit optimální počet oblastí, aby se dosáhlo co nejlepšího kompromisu mezi rychlostí a přesností.
Zaokrouhlení. Aby se index do paměti vešel, polohy bodů v něm nejsou uložené přesně, ale jsou uložené v komprimované podobě. Ve výpočtu vzdálenosti, podle kterých se výsledky řadí, proto mohou vznikat odchylky. Dvě rozhodnutí, která jsou od otázky podobně daleko, může index seřadit v opačném pořadí, než jak by to vyšlo v ideálním případě.
Žádná z těchto věcí není chyba v návrhu, nýbrž kompromis mezi rychlostí a přesností, který se vnáší do každého softwarového systému. Ve finále toto není pro uživatele podstatné. Důležité je pro něj hlavně to, aby se mohl spolehnout na výsledky.
Jak se měří, jestli vyhledávání funguje
U vyhledávání je snadné podlehnout dojmu. Zkusíte tři otázky, vrátí se něco rozumného, a vypadá to hotově. Jenže tři otázky neříkají nic o čtvrté.
Postavili jsme proto testovací sadu otázek, u kterých předem víme, které rozhodnutí má systém najít. Postupovali jsme podle následujících dvou pravidel:
Zaprvé, otázky jsou psané tak, jak je lidé skutečně kladou, nikoli jako právní věta. „Nájemník pronajímá byt přes Airbnb. Můžu mu dát výpověď?“ Právě rozdíl mezi tím, jak se ptá člověk a jak píše soud, je to, co má vyhledávání překonat, takže to test musí zohlednit a obsahovat.
Zadruhé, ke každé otázce je spisová značka rozhodnutí, které ji řeší, ověřená proti zdroji, který uvádí značku i to, co rozhodnutí stanovilo a jaký byl výrok soudu. Když stejné pravidlo vyslovilo více rozhodnutí, uznáváme kterékoli z nich.
Testovací sada má 46 skutečných otázek z právních webů a pokrývá rodinné právo, pracovní právo, nájem, spotřebitelské úvěry, náhradu újmy, daně, insolvenci, trestní právo, správní řízení, státní službu a cizinecké právo.
Na této sadě dnes Právobot najde správné rozhodnutí mezi prvními dvaceti výsledky u 40 otázek ze 46. Když projdete prvních šedesát výsledků, je to 43 otázek ze 46.
Oproti fulltextovému vyhledávání je to velký posun. Výsledky nepřicházejí v nahodilém pořadí, které je potřeba pročíst celé, ale jsou seřazené podle toho, jak blízko mají k vaší otázce, a správné rozhodnutí bývá mezi prvními z nich.
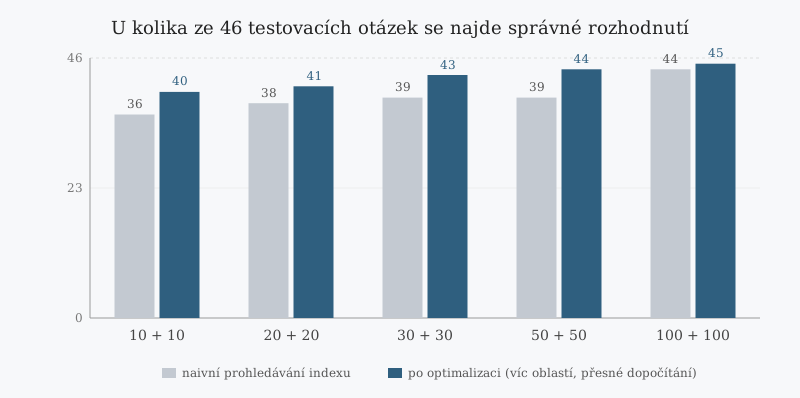
Většina chyb nevznikla tím, že by systém otázce nerozuměl. Správné rozhodnutí leželo na mapě blízko otázky, ale index ho přeskočil, protože bylo za hranicí prohledaných oblastí nebo ho zaokrouhlená vzdálenost odsunula níž. Právobot proto prohledává širší okolí otázky a u nejlepších kandidátů přepočítává vzdálenost přesně. Tím se většina těchto chyb odstraní.
Co mapa nenajde, najdou citace
Některá rozhodnutí na mapě nenajdete, ať je index nastavený jakkoli. Soudy často vysloví obecné pravidlo jen mimochodem, při řešení konkrétního sporu. Nález Ústavního soudu z roku 1997, podle kterého soud není vázán doslovným zněním zákona, se formálně týká jiné věci. Jeho shrnutí proto popisuje tento konkrétní spor a otázka na výklad zákona se k němu na mapě nedostane.
Najde ale rozhodnutí, která tento nález citují. Z každého rozhodnutí v databázi jsme proto vytáhli odkazy na jiná rozhodnutí a vznikla síť toho, kdo koho cituje. U výsledků z mapy se díváme, na co odkazují a kdo odkazuje na ně. Když se několik nalezených rozhodnutí odvolává na stejný starší nález, nejspíš k otázce patří, i když ho mapa nevrátila. Takto nalezená rozhodnutí tvoří druhou polovinu výsledků.
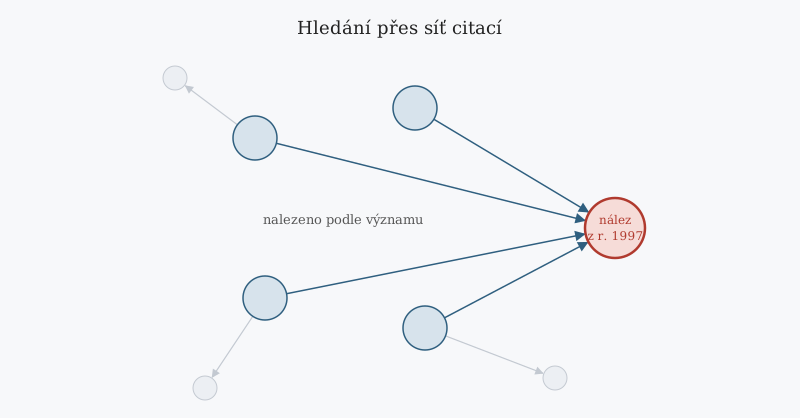
Tímto způsobem se do výsledků dostávají „slavná“ rozhodnutí, která se citují kvůli obecnému pravidlu, ne kvůli sporu, který řešila. V testovací sadě se to týkalo šesti otázek. Citace mají i nevýhodu. Rozhodnutí, které cituje skoro každý, se objeví i u otázek, se kterými souvisí jen vzdáleně. Na lepším řazení citací dál pracujeme.
Na co si dát pozor
Vyhledávání nepozná překonanou judikaturu. Na otázku o náhradě újmy vrací mimo jiné rozhodnutí Nejvyššího soudu z let 2003 až 2005, která Ústavní soud později překonal. Řeší stejnou otázku, a proto leží na mapě blízko. Řeší ji ale jinak, než se rozhoduje dnes. Shrnutí zatím informaci o překonání neobsahuje, takže aktuálnost si musíte ověřit sami, stejně jako v jakékoli jiné databázi.
Obecná pravidla se hledají hůř než konkrétní spory. Pokud je rozhodnutí známé kvůli pravidlu, které soud vyslovil mimochodem, a shrnutí ho nezachytilo, ve výsledcích se objevit nemusí. Pomáhá zeptat se konkrétněji, na situaci, ve které se pravidlo použilo.
Shrnutí
Vektorové vyhledávání se hodí tam, kde víte, co hledáte, ale nevíte, jak to soud formuloval. Stačí situaci popsat vlastními slovy a projít prvních dvacet výsledků. U rozhodnutí, o která se chcete opřít, je ale potřeba ověřit, jestli stále platí. Pokud znáte spisovou značku nebo přesnou formulaci, bude fulltextové vyhledávání rychlejší.
Vyzkoušejte Právobot zdarma.
Vyzkoušet zdarma →